- Publicado el
🏗️ Harness Engineering


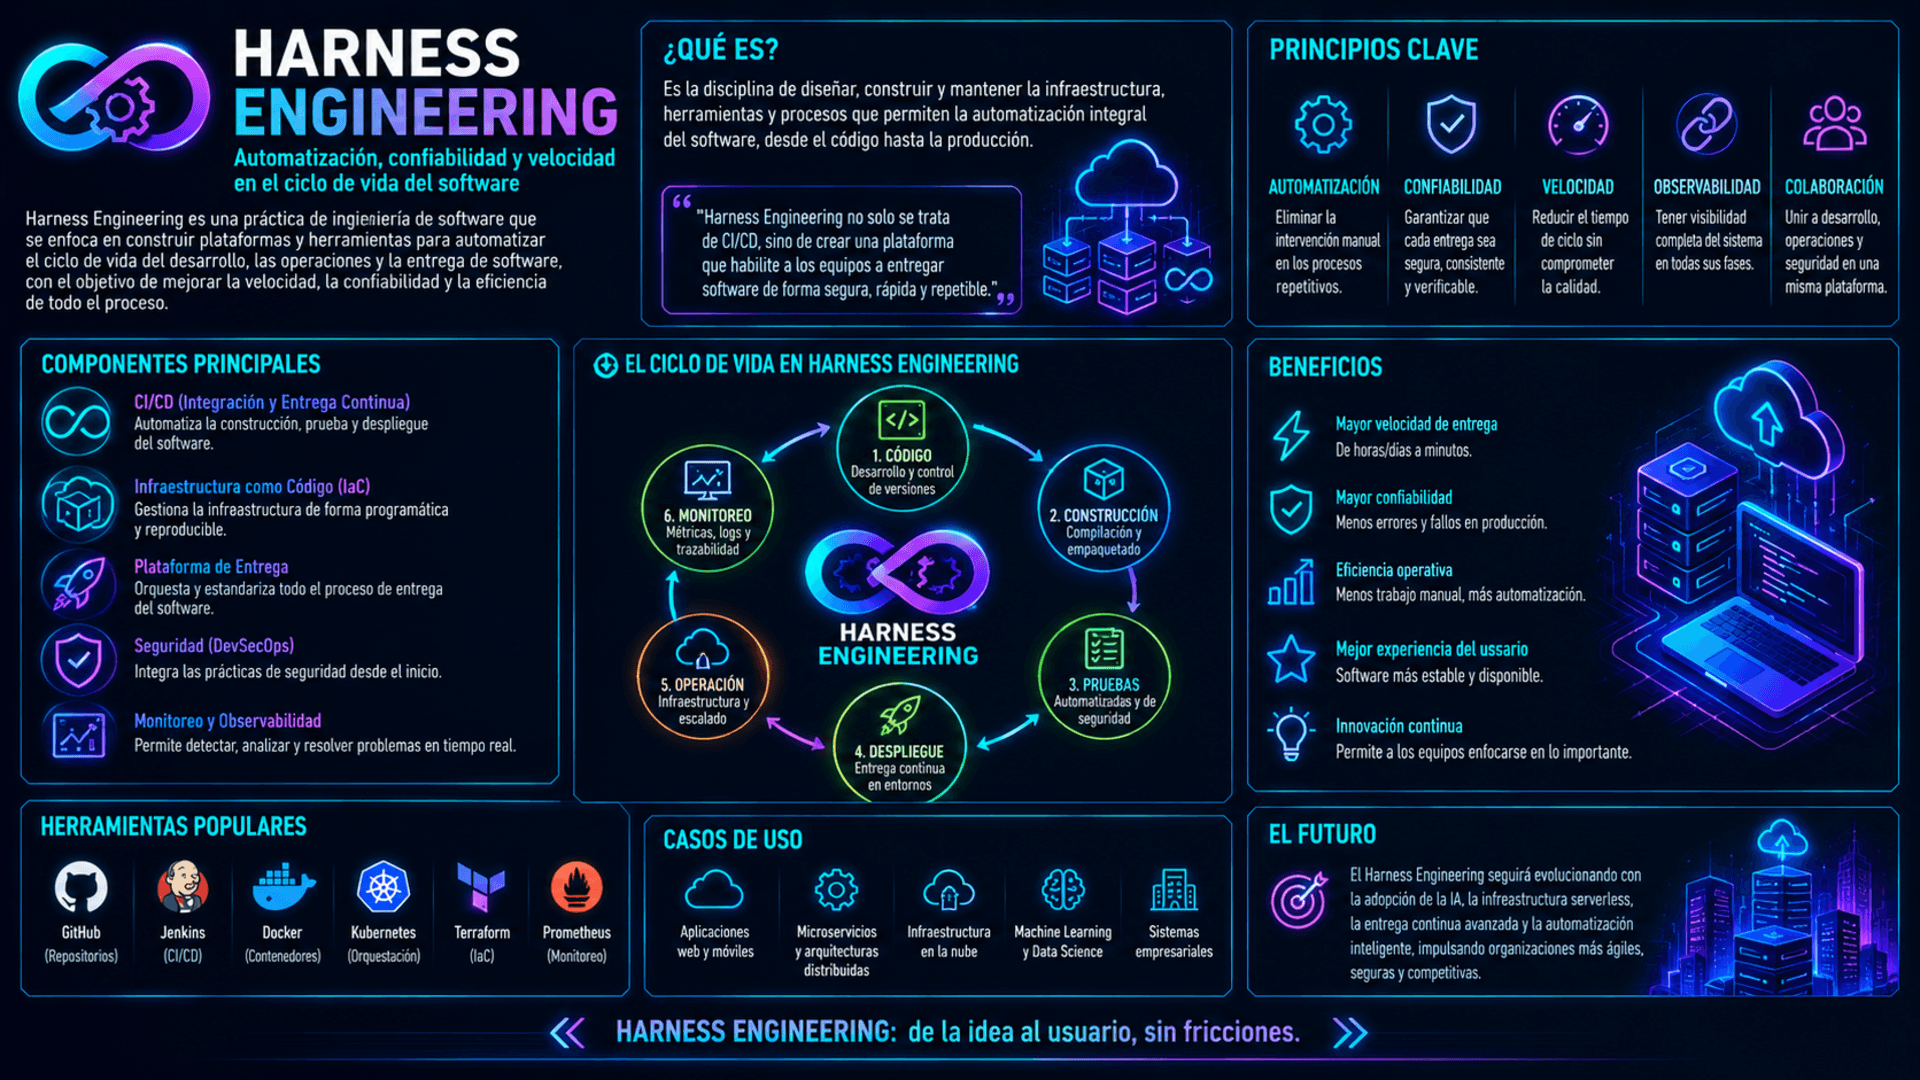
El concepto ganó especial relevancia en 2026 a partir de las experiencias de equipos que desarrollan software con agentes de codificación como Codex. El cambio de enfoque de forma muy clara: el trabajo del ingeniero pasa de escribir directamente cada línea de código a diseñar el sistema que permite al agente producir software confiable.
Es la disciplina que construye la "infraestructura de seguridad y control", "the harness" que rodea, guía y limita a la Inteligencia Artificial para que no destruya la producción ni alucine resultados.
👉 El concepto de Harness Engineering "o Ingeniería de Harness/Arneses para IA" representa la evolución crítica en el diseño de software para la era de los agentes autónomos.
🧠 Harness Engineering: La infraestructura de control para Agentes de IA
Cuando pasamos de usar modelos de lenguaje como simples chats "donde una mala respuesta es solo un texto feo" a desplegar agentes autónomos, "que ejecutan comandos en la terminal, modifican bases de datos y realizan despliegues en la nube", el riesgo técnico se multiplica por mil.
Un agente con acceso ilimitado al sistema puede borrar una base de datos por error, entrar en un bucle infinito que agote tu crédito en AWS en minutos o filtrar información confidencial.
La Harness Engineering es la rama de la ingeniería de software dedicada a diseñar, construir y auditar los entornos aislados "sandboxes", las interfaces de herramientas "tooling APIs" y las barreras de seguridad "guardrails" que permiten a los agentes de IA operar de forma autónoma pero 100% segura.
🧠 ¿Qué significa "Harness"?
En inglés, harness puede referirse a un arnés: un conjunto de elementos que permite controlar y dirigir la fuerza de un sistema.
En IA podemos pensar:
                 MODELO DE IA
                      │
                 "capacidad"
                      │
                      ▼
              ┌───────────────┐
              │    HARNESS    │
              │               │
              │ Contexto      │
              │ Herramientas  │
              │ Restricciones │
              │ Tests         │
              │ Observabilidad│
              │ Seguridad     │
              │ Feedback      │
              └───────┬───────┘
                      │
                      ▼
              TRABAJO CONFIABLE
👉 En el contexto de IA, el Harness es el software que envuelve al modelo de lenguaje "LLM" y actúa como su mediador con el mundo exterior:
┌─────────────────────────────────────────────────────────────┐
│                      SISTEMA EXTERNO                        │
│         (Servidores, APIs, Archivos, Base de Datos)         │
└──────────────────────────────┬──────────────────────────────┘
                               │
               ┌───────────────┴───────────────┐
               │    HARNESS (EL ARNÉS)         │
               │  • Sandbox & Aislamiento      │
               │  • Control de Permisos        │
               │  • Límite de Presupuesto/Rate │
               │  • Formateo de Herramientas   │
               └───────────────┬───────────────┘
                               │
                               ▼
┌─────────────────────────────────────────────────────────────┐
│                       AGENTE DE IA                          │
│          (OpenCode, OpenClaw, Devin, Claude Agent)          │
└─────────────────────────────────────────────────────────────┘
👉 El harness determina qué puede observar, qué puede hacer, cómo recibe información, cómo se verifica su trabajo y qué ocurre cuando falla.
🤖 ¿Por qué aparece Harness Engineering?
En el desarrollo tradicional:
Humano
  ↓
Escribe código
  ↓
Ejecuta pruebas
  ↓
Corrige
  ↓
Despliega
Con agentes de IA:
Humano
  ↓
Define objetivo
  ↓
Agente IA
  ↓
Analiza
  ↓
Escribe código
  ↓
Ejecuta herramientas
  ↓
Prueba
  ↓
Corrige
  ↓
Repite
El problema es que un agente puede:
- interpretar incorrectamente un requisito;
- modificar archivos equivocados;
- utilizar una API incorrectamente;
- introducir regresiones;
- quedarse atrapado en un ciclo;
- generar código que funciona pero viola la arquitectura;
- repetir patrones deficientes existentes.
Por eso no basta con tener un modelo potente.
👉 Hay que construir un entorno que permita al agente trabajar correctamente.
⚙️ Arquitectura conceptual
Podemos representar un Harness de esta manera:
                  ┌─────────────────┐
                  │    HUMANO       │
                  │ Intención /     │
                  │ objetivos       │
                  └────────┬────────┘
                           ↓
                  ┌─────────────────┐
                  │     AGENTE      │
                  │       IA        │
                  └────────┬────────┘
                           ↓
        ┌──────────────────┼──────────────────┐
        ↓                  ↓                  ↓
   CONTEXTO            HERRAMIENTAS       MEMORIA
        │                  │                  │
        └──────────────────┼──────────────────┘
                           ↓
                    ┌──────────────┐
                    │  EJECUCIÓN   │
                    └──────┬───────┘
                           ↓
                    ┌──────────────┐
                    │ VERIFICACIÓN │
                    └──────┬───────┘
                           ↓
                    ┌──────────────┐
                    │  FEEDBACK    │
                    └──────┬───────┘
                           │
                           └──────→ Agente
👉 El agente trabaja dentro de un ciclo de observación → acción → verificación → corrección.
🧩 Componentes principales
1. 📚 Contexto
El agente necesita conocer el proyecto.
Pero darle toda la información indiscriminadamente tampoco funciona bien.
Una de las conclusiones, fue que era mejor proporcionar al agente un mapa del conocimiento que un enorme manual de instrucciones. En su caso, AGENTS.md funciona como índice hacia documentación más profunda almacenada en el repositorio.
Por ejemplo:
AGENTS.md
    │
    ├── Arquitectura
    ├── Convenciones
    ├── Testing
    ├── Seguridad
    └── Documentación
👉 Esto se conoce como hacer que el repositorio sea legible para el agente.
2. 🛠️ Herramientas
El agente necesita herramientas para actuar.
Por ejemplo:
Agente
  │
  ├── Terminal
  ├── Git
  ├── Editor
  ├── Tests
  ├── Browser
  ├── APIs
  ├── Logs
  └── Base de datos
La diferencia fundamental es:
LLM tradicional
→ genera texto

Agente + Harness
→ observa → decide → ejecuta → verifica
3. 🔒 Restricciones y guardrails
Un agente poderoso necesita límites.
Por ejemplo:
❌ No modificar producción directamente
❌ No eliminar bases de datos
❌ No acceder a secretos
❌ No modificar determinadas carpetas

✅ Ejecutar tests
✅ Crear ramas
✅ Modificar código permitido
✅ Ejecutar linters
La idea no es decirle al agente exactamente cómo implementar cada cosa.
👉 La idea es definir qué está permitido y qué debe cumplirse.
4. 🧪 Verificación
Este es uno de los elementos más importantes.
El agente no debería simplemente decir:
"Ya terminé."
El sistema debería comprobarlo.
Implementación
      ↓
Tests
      ↓
Lint
      ↓
Type checking
      ↓
Tests de integración
      ↓
Evaluación
      ↓
¿Todo correcto?
   ↙          ↘
 NO            SÍ
 ↓              ↓
Corregir       Finalizar
👉 Aquí existe una relación muy interesante con TDD:
TDD
↓
Define comportamiento verificable

Harness Engineering
↓
Hace que el agente pueda verificar
automáticamente ese comportamiento
5. 📊 Observabilidad
Un agente necesita poder ver lo que está ocurriendo.
Por ejemplo:
Aplicación
    │
    ├── Logs
    ├── Métricas
    ├── Traces
    └── Screenshots
             │
             ↓
          Agente
🔄 El feedback loop
Una característica fundamental del Harness Engineering es el ciclo de retroalimentación.
        ┌───────────────┐
        │    Objetivo   │
        └───────┬───────┘
                ↓
        ┌───────────────┐
        │     Agente    │
        └───────┬───────┘
                ↓
        ┌───────────────┐
        │    Ejecuta    │
        └───────┬───────┘
                ↓
        ┌───────────────┐
        │   Verifica    │
        └───────┬───────┘
                ↓
          ¿Correcto?
           ↙     ↘
         NO       SÍ
         ↓         ↓
     Feedback    Finalizar
         │
         └──────────→ Agente
👉 Cuanto mejor sea este ciclo, mayor autonomía puede tener el agente.
🏛️ Arquitectura y reglas
Imaginemos un proyecto con esta arquitectura:
Types
  ↓
Config
  ↓
Repository
  ↓
Service
  ↓
Runtime
  ↓
UI
El agente podría intentar hacer:
UI ─────────→ Repository
Pero nuestra arquitectura establece:
UI → Runtime → Service → Repository
El Harness puede detectar automáticamente la violación mediante:
- linters;
- análisis estático;
- pruebas estructurales;
- reglas CI/CD.
Así:
Agente
  ↓
Código
  ↓
Architecture Linter
  ↓
❌ Violación
  ↓
Feedback
  ↓
Agente corrige
👉 Esto permite que la arquitectura sea ejecutable y verificable, no solamente un documento que alguien debe recordar.
🧹 "Garbage Collection" del código
Existe otro concepto interesante.
Los agentes tienden a copiar los patrones que encuentran en el repositorio.
Si un patrón incorrecto entra al proyecto:
Código incorrecto
      ↓
Agente lo copia
      ↓
Más código incorrecto
      ↓
Otro agente lo copia
      ↓
📈 Entropía
👉 Por eso Harness Engineering incorpora procesos automáticos de limpieza y mantenimiento.
Repositorio
     ↓
Scanner
     ↓
Detectar desviaciones
     ↓
Crear tarea
     ↓
Agente refactoriza
     ↓
Tests
     ↓
Merge
Este proceso se describe como una especie de garbage collection para evitar que la deuda técnica y los patrones deficientes se acumulen.
👨💻 ¿Qué cambia para el desarrollador?
Esta es probablemente la parte más importante.
Desarrollo tradicional
El ingeniero dedica mucho tiempo a:
Diseñar
 ↓
Programar
 ↓
Depurar
 ↓
Probar
 ↓
Refactorizar
Desarrollo con agentes + Harness Engineering
El ingeniero pasa a dedicar más tiempo a:
Definir objetivos
       ↓
Diseñar arquitectura
       ↓
Diseñar herramientas
       ↓
Definir restricciones
       ↓
Crear pruebas
       ↓
Crear feedback loops
       ↓
Supervisar agentes
Por eso podemos resumir el cambio como:
El ingeniero deja de concentrarse exclusivamente en escribir código y empieza a diseñar el sistema en el que los agentes escriben y mantienen código.
🆚 Prompt Engineering vs Harness Engineering
| Prompt Engineering | Harness Engineering | |
|---|---|---|
| Enfoque | Instrucción | Sistema |
| Principal herramienta | Prompt | Infraestructura |
| Contexto | Texto proporcionado | Contexto + repositorio + herramientas |
| Validación | Respuesta | Tests + herramientas + feedback |
| Seguridad | Instrucciones | Permisos + sandbox + políticas |
| Automatización | Limitada | Alta |
| Escalabilidad | Menor | Mayor |
Una forma sencilla:
Prompt Engineering
      ↓
"¿Cómo le digo al agente qué hacer?"

Harness Engineering
      ↓
"¿Cómo construyo un entorno donde pueda
hacerlo correctamente y demostrar que lo hizo?"
🆚 TDD vs Harness Engineering
También podemos relacionarlo con el concepto anterior:
| TDD | Harness Engineering |
|---|---|
| Orientado a pruebas | Orientado al entorno del agente |
| Prueba antes del código | Contexto + herramientas + restricciones + feedback |
| Valida comportamiento | Valida y controla el trabajo del agente |
| Principalmente desarrollo | Arquitectura del sistema agente |
| Red → Green → Refactor | Ejecutar → Verificar → Feedback → Corregir |
De hecho, pueden complementarse:
              Harness Engineering
                      │
        ┌─────────────┼─────────────┐
        ↓             ↓             ↓
      TDD          Linters       CI/CD
        ↓             ↓             ↓
        └─────────────┼─────────────┘
                      ↓
                 AGENTE IA
🦞 Relación con OpenClaw y OpenCode
Esto conecta directamente con los temas que hemos visto.
Los agentes como OpenCode y OpenClaw pueden considerarse ejemplos del tipo de sistemas en los que el harness es fundamental: el agente necesita herramientas, contexto, ejecución, permisos y mecanismos de control.
Podemos visualizarlo así:
                 MODELO IA
                    │
                    ↓
              ┌───────────┐
              │  HARNESS  │
              └─────┬─────┘
                    │
       ┌────────────┼────────────┐
       ↓            ↓            ↓
   OpenCode      OpenClaw      Codex
       │            │            │
       ↓            ↓            ↓
    Código       Agente       Código
🚀 Harness Engineering + Spec-Driven Development + TDD + BDD
Aquí aparece una combinación muy interesante:
                 REQUISITO
                    ↓
          Spec-Driven Development
                    ↓
              Especificación
                    ↓
                   BDD
                    ↓
            Comportamientos
                    ↓
                   TDD
                    ↓
                Pruebas
                    ↓
          Harness Engineering
                    ↓
          Agente IA + herramientas
                    ↓
              Implementación
                    ↓
          Verificación automática
                    ↓
                 SOFTWARE
Cada disciplina resuelve una parte diferente:
- Spec-Driven Development → define qué se debe construir.
- BDD → define cómo debe comportarse para el usuario.
- TDD → convierte comportamientos en pruebas verificables.
- Harness Engineering → crea el entorno que permite al agente implementar, comprobar y corregir todo lo anterior.
🧠 La idea fundamental
Podemos resumir Harness Engineering con esta fórmula conceptual:
        Agente confiable
              =
        Modelo de IA
              +
          Contexto
              +
         Herramientas
              +
        Restricciones
              +
         Verificación
              +
        Observabilidad
              +
       Feedback loops
No es una fórmula matemática formal, sino una forma de entender el concepto.
👉 La investigación académica reciente también propone ver al agente como un sistema modelo + harness + entorno, donde el harness media entre lo que el modelo observa, las acciones que puede realizar y la manera en que se determina que una tarea está terminada correctamente.
🏁 Resumen
A medida que la Inteligencia Artificial avanza, los modelos en sí se están volviendo commodities "intercambiables entre OpenAI, Anthropic o modelos locales". El verdadero valor de la ingeniería de software moderna no estará en entrenar los modelos, sino en la Harness Engineering: construir los sistemas de contención elegantes, seguros y escalables que permitan a la IA trabajar en el mundo real sin supervisiones humanas constantes.
Sintetizando, el Harness Engineering es la disciplina de diseñar el "sistema de soporte" alrededor de un agente de IA para que pueda trabajar de forma confiable, verificable y escalable.
👨💻 HUMANO
│
│ intención
↓
🤖 AGENTE IA
│
┌──────────┼──────────┐
↓ ↓ ↓
Contexto Herramientas Reglas
│ │ │
└──────────┼──────────┘
↓
EJECUCIÓN
↓
🧪 TESTS
↓
📊 OBSERVABILIDAD
↓
FEEDBACK
│
└──────→ 🤖 AGENTE